
先回到 Day 01 的結論:它只做一件事 - 看完前面所有的字,輸出下一個字的機率,抽一個,再做一次。沒有第二個動作。
如果真的只有這一個動作,那「認出這是什麼任務」是從哪冒出來的?
不是。它是被猜字這件事逼出來的。
理由很簡單:文字不是均勻的。 同樣一個開頭,接下去會長什麼樣,完全取決於這是什麼種類的東西。「本季營收」後面接什麼,在財報裡跟在抱怨文裡差很多。所以一個不知道自己在讀什麼的模型,猜得一定比知道的那個差。
推論「這是什麼」不是額外的功能,而是把猜錯率壓低最划算的一條路。 統計壓力自己會把它長出來。
接下來只差一步:你跟它講的話,也是一種文件。
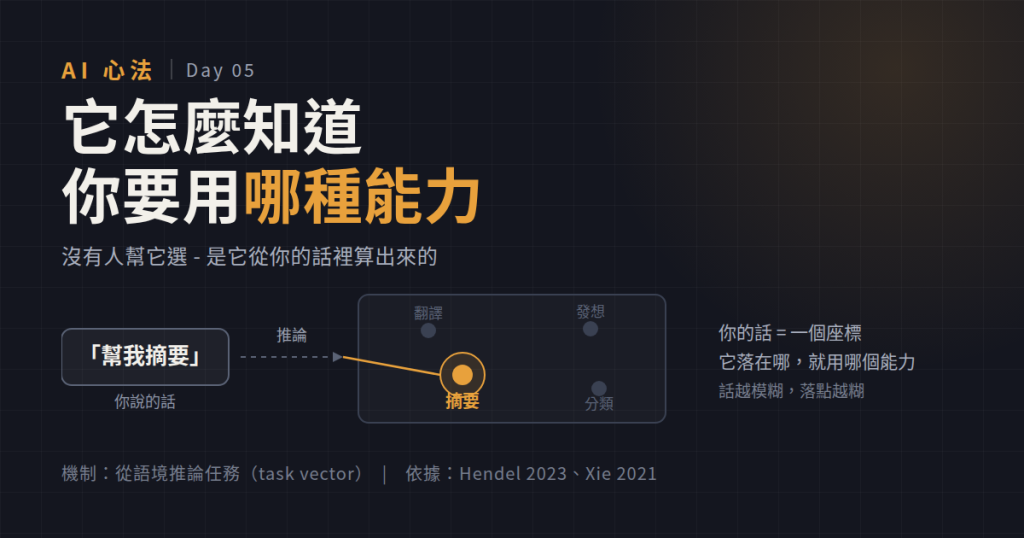
「幫我摘要以下內容:」就是一種開頭。同一套機制,推論的對象從「這是一封客服信」換成「這是一個摘要任務」 - 任務只是另一個要被猜出來的東西。
Day 01 講過 Othello-GPT:一個模型只看得到棋譜、沒看過棋盤、沒人教它規則,唯一的任務是猜下一手。訓練完剖開來看,它自己在腦中畫出了一張棋盤。
把它跟這篇的任務向量並排,會發現形狀一模一樣:
| 黑白棋(Day 01) | 任務向量(今天) | |
|---|---|---|
| 訓練目標 | 只是猜下一手 | 只是猜下一個字 |
| 被逼出來的東西 | 棋盤現在長什麼樣 | 這段話是什麼任務 |
| 怎麼證明它真的存在 | 動手改棋盤 → 棋步跟著變 | 抽出向量貼過去 → 任務跟著變 |
兩個實驗連驗證的手法都一樣:動內部那個東西,行為跟著動。 這是「它真的在那裡」最硬的一種證據。
所以從外面看,像是「它選了摘要這個能力」;從裡面看,只是它推出這段話是摘要類型,於是下一個字的機率就往那邊收窄了。
這也代表一件事:根本沒有人需要幫它選。
這跟多數人的直覺相反。最自然的猜測是:背後有一張表,或有一段設定,寫著「遇到什麼要用什麼」 - 畢竟它分得那麼準。
但這個猜測有一個很乾脆的反證:把所有設定清空、直接送一句話進去,它照樣分得出來。 沒有任何地方寫著「摘要請走這條」。
所以答案跟上一節推出來的一致:那個選擇是推論出來的,而推論這件事是訓練出來的。
這也是為什麼它偶爾會選錯 - 推論本來就會推錯,而你手上沒有一個開關可以糾正它,只能改你給的線索。
以 Claude Opus 5 為例,跟「你怎麼下 prompt」比較有直接關係的有六層。前五層在訓練時就長好了,你完全動不了;只有最後一層在你每次送出請求時才發生,而且你也只能建議。
| # | 層 | 什麼時候 | 你能動嗎 | 決定什麼 |
|---|---|---|---|---|
| 1 | 預訓練 | 訓練時 | 不能 | 這段話的潛在任務是什麼 |
| 2 | 指令微調 | 訓練時 | 不能 | 聽得懂用講的下指令 |
| 3 | 偏好訓練 | 訓練時 | 不能 | 回答的形狀、什麼該拒絕 |
| 4 | 性格訓練 | 訓練時 | 不能 | 語氣、好奇心、怎麼權衡 |
| 5 | 推理訓練 | 訓練時 | 不能 | 什麼時候該多想一下 |
| 6 | 自適應思考 | 每次請求 | 只能建議 | 這題要不要想、想多久 |
選哪個能力,只發生在第 1、2 層。 但第 3 到 6 層會實質改變你拿到的東西 - 而它們最容易被忽略,因為它們沒有開關。
上一節那套推論,2021 年 Xie 等人給了它一個名字:隱式貝氏推論。白話講就是「模型在心裡一直押著這是哪一種東西,而且邊看邊改押注」。
而 2023 年有兩組研究各自找到了直接證據。舉個例子:
先給模型看「法國→巴黎、日本→東京、埃及→開羅」,這時它在做「查首都」這個任務。研究者把模型內部的狀態抽出來,發現這個任務被壓縮成單一一個向量。接著換一個全新的字、而且不給任何示範,例如只丟一個「德國」,把剛才那個向量貼回去 - 模型直接答出「柏林」。它沒看到半個示範,卻做了查首都這件事,因為那個「任務」被當成一個東西搬了過去。
這代表模型裡真的存在一個「我現在要做什麼」的東西,而且它可以被抽出來、搬走、貼到別的地方。不是隱喻,是一個可以拿在手上的物件。換成白話:它不是查表決定「要用摘要能力」,而是從你的話裡算出一個座標。
第 1 層解決了「從語境認出任務」,但沒解決「聽得懂命令」。光靠第 1 層,你得給範例它才知道要幹嘛。
補上這一塊的是指令微調。2021 年的 FLAN 是代表作:拿一個模型,在 60 多個任務(後來擴到 1,800 多個)上微調,每一個任務都用自然語言指令包起來。結果是在訓練時沒見過的任務類型上,表現大幅提升。
消融實驗指出三個要素缺一不可:任務數量、模型規模、以及有沒有用自然語言指令包裝。最後那項最說明問題 - 同樣的資料,不包成指令,效果就掉下來。
所以這一層教會的不是「怎麼摘要」(第 1 層就會了),而是「聽到『摘要一下』這四個字,要對應到哪一個座標」。
舉個例子: 你直接打「幫我把這段濃縮成三句話」,它就懂了 - 你不需要先貼三組「長文→短摘要」的示範。這個「用講的就會」正是第 2 層裝上去的;沒有它,你得像第 1 層那樣先給範例。
這三層都不決定用哪種能力,但都會改變你拿到的東西。
第 3 層 偏好訓練 - 決定回答的形狀:多長、要不要列點、要不要先給結論、要不要加但書。Claude 這一層的特色是憲法 AI:先讓模型照一份寫好的原則自我批判並修訂自己的回答,再用模型自己的回饋跑強化學習,而不是全靠人工標註。(例:同樣問「什麼是 RAG」,它傾向先給一句定義再展開,而不是丟一大段沒分段的文字 - 這個習慣是這一層養的。)
第 4 層 性格訓練 - Anthropic 另外做了一個「性格版」的同套方法:讓模型自己產生回應、自己排序哪個最符合那個性格,再拿這批資料訓練。官方明講這不只是體驗設計,它也會影響模型判斷什麼情況該拒絕。(例:你講錯一件事,它傾向溫和地指出而不是嘲諷 - 這個調性不是你 prompt 出來的,是這一層。)
第 5 層 推理訓練 - 用「答案可以程式化判定對錯」的題目做強化學習。重點是副作用:這樣訓練出來的模型會養成一種生成式搜尋的習慣 - 列出幾條暫時的分支、修改中間步驟、明確地自我修正。(例:問一道數學題,它會先寫「讓我試試這個方法……不對,換一個」再給答案 - 這種自我修正的習慣是這一層長出來的。)
第 5 層就是為什麼現在的模型會「自己決定要想多久」。那個判斷力是訓練出來的,不是規則寫死的。
Opus 5 預設就會思考,而且由模型自己決定這題要不要想、想多深。官方的說法是:會不會思考、想多深,取決於你的設定與請求的複雜度。
你手上確實有一顆旋鈕(effort),但官方明講它是「行為訊號,不是嚴格的預算」 - 設低了,遇到夠難的題目它還是會想,只是想得比高的時候少。
而且你看不到它真正想了什麼:回傳的思考內容永遠是摘要,不是原始思路,很多情況下預設甚至整段空白。
舉個例子: 同樣問一句「1+1 等於幾」和「證明這個演算法的時間複雜度」,前者它幾乎不思考就答,後者會先想一大段再回答 - 你沒下任何指令,是它自己看題目難度決定的。
把六層對應回實際做法,有三條。
既然那個座標是從你的話裡算出來的,話越模糊,算出來的位置越糊。
而且回頭看第 1 層那個實驗:任務向量是從示範例子裡抽出來的。範例不是「多給一點資料」 - 範例是你操作那個座標最直接的介面。
自己試: 同一份會議記錄,比較這兩種說法拿到的東西差多少:
| 說法 | 它要猜什麼 |
|---|---|
| 「幫我整理得專業一點」 | 「專業」是什麼?座標大概落在中間某處 |
| 「像這樣:決議:X | 負責人:Y | 期限:Z,把全部列出來」 | 座標被範例釘死了 |
「你是一位資深分析師」動的是第 3、4 層(語氣),動不到第 1 層(任務)。要改任務就直接寫動作:「先把資料裡的數字抽出來,再判斷哪些重要」。
不過「人設沒用」講得太滿了。準確的版本要看你想要的是什麼:
| 你想要的 | 人設有沒有用 |
|---|---|
| 做對某件事(分析、計算、整理) | 沒用,有實證 |
| 換個說法(風格本身就是產出) | 有用 - 但這時它其實是在指定任務 |
| 講話的調性(附帶在別種任務上) | 有點用,但直接寫行為更準 |
中間那列是關鍵:當「換一種說法」本身就是任務時,人設不是在指定語氣,它是在指定任務 - 所以它餵的是第 1 層,當然有用。
至於第三列,人設只是一個低解析度的說法。「你是一位資深分析師」是丟一個標籤讓它自己猜那包含什麼;「用術語、不解釋基礎概念、每個判斷附上理由」是直接講。想要某種語氣,先問自己能不能把它寫成一條可以檢查的行為 - 能的話就寫那條。
思考深度是第 5、6 層在管的,而它判斷的依據是請求的複雜度。
所以「請仔細思考」這種話不是沒用,但它是在跟模型商量,不是在下指令。真正的槓桿是把難度本身講出來:有幾個限制條件、要在什麼之間權衡、做錯了會怎樣。這些才是它判斷要想多久的輸入。
這條最容易被忽略。
你叫它「先抽取再統整」,它回答裡寫「我先抽取了以下要點……」 - 那段話不構成它真的這樣做了的證據。
有兩個獨立的理由:
所以 Day 03 那條「驗證必須來自外部」,在這裡有了第二個理由:不只它不會發現自己錯了,連它對自己步驟的描述也不可靠。 要確認它有沒有做某一步 - 看產出對不對,不要看它說它做了什麼。
今天這篇往裡面看了一層,結論其實很短:
你不是在下指令,你是在給它足夠的線索,讓它推論出你要什麼。
Day 01 說「沒有第二個動作了」。今天這六層沒有推翻那句 - 它們全部都是「把那一個動作做好」長出來的東西。
推論會推錯。你以為你在要「統整」,它推成「摘要」,於是你拿到一份忠實但沒有新判斷的整理。修法不是把同一句話再講一次大聲一點,是換成它推理不偏的說法。


 iThome鐵人賽
 看影片追技術